Bahçeşehir大学の
要点
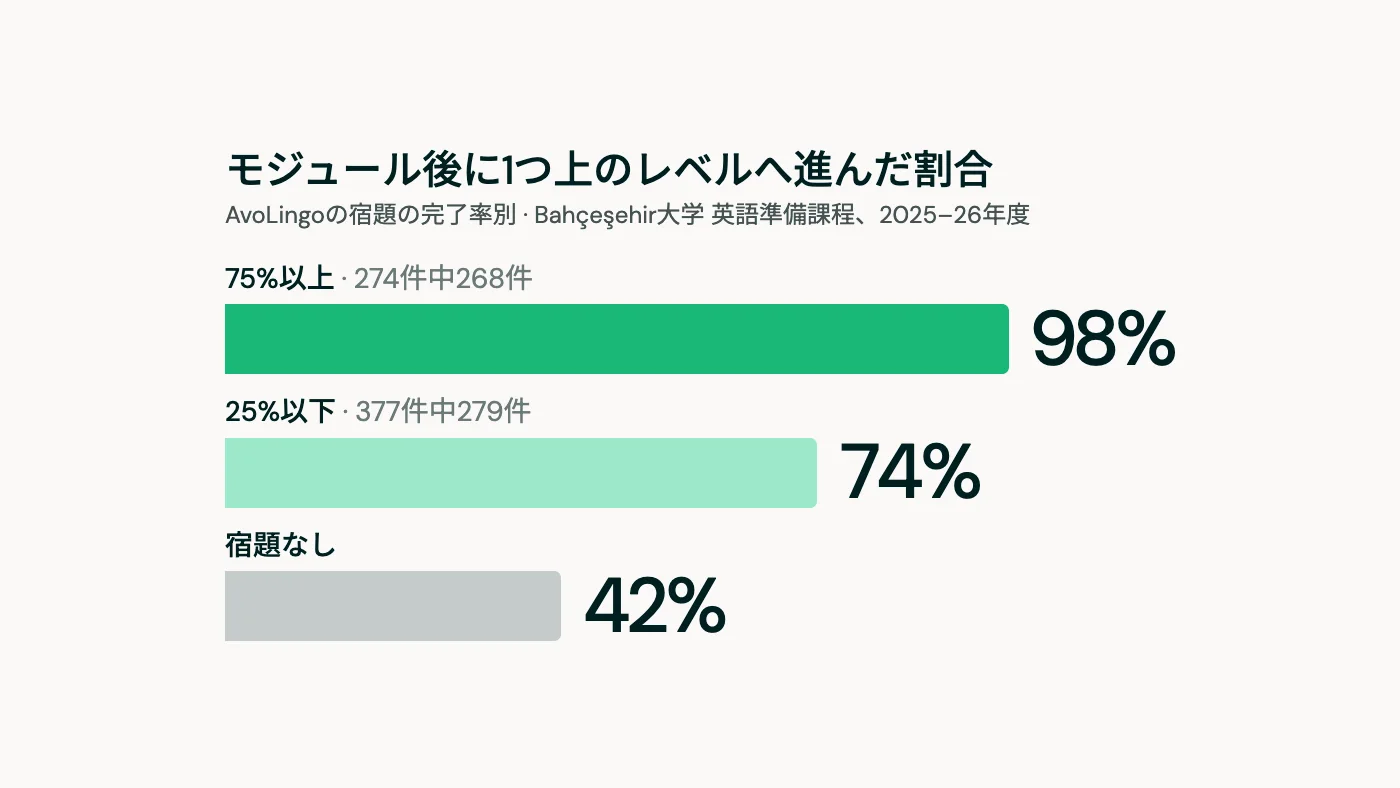
- 2025–26年度のBahçeşehir大学英語準備課程では、モジュール内でAvoLingoの宿題を75%以上完了した学生は、98%のケースで1つ上のレベルに進みました(274件中268件)。
- 完了が25%以下だった場合、1つ上のレベルに進んだ割合は74%でした(377件中279件)。そのモジュールで宿題をまったくしなかった場合は42%でした。
- 誰が上のレベルに進むかを決めたのは学校で、AvoLingoのスコアは使われていません。データの対象は、1学年度にわたる学生1,033人です。
- これは1校の観察データで、対照試験ではありません。示しているのは、宿題の完了と進歩が連動していたことであり、一方がもう一方の原因だということではありません。
AIスピーキング宿題に効果はある?
このデータでは、条件つきで「はい」です。AIスピーキング宿題の大半を行った学生は、まったく行わなかった学生よりも、はるかに高い割合で1つ上のレベルに進みました。98%に対して42%です。これは、1つの大学の準備課程で1年間に見られた強い関連です。宿題が進歩の原因だという証明ではありません。その理由をこの記事で説明します。
数値は、トルコのBahçeşehir大学(BAU)英語準備課程(English Preparatory School)のAvoLingoプラットフォームのデータを、各モジュール終了時の学校自身の判定と照合したものです。
| モジュール内で完了したAvoLingoの宿題 | 1つ上のレベルに進んだ割合 | 件数 |
|---|---|---|
| 75%以上 | 98% | 274件中268件 |
| 25%以下 | 74% | 377件中279件 |
| 宿題なし | 42% | 当社の分析要約に件数の記載なし |
件数はいずれも人数ではなく、モジュール結果の数です。モジュール結果とは、1人の学生が8週間のモジュール1つを終えた時点での結果を指します。1年を通して学んだ学生は、複数回数えられています。
当社の分析要約が示しているのは、この範囲の両端です。中間については数値が1つだけあります。宿題の半分より多くを完了した学生は、どのレベルでも88%以上の割合で上のレベルに進みました。
出典:AvoLingoプラットフォームのデータ、Bahçeşehir大学英語準備課程、2025年10月〜2026年5月。
何を、どのように測定した?
学生がモジュール内でAvoLingoの宿題をどれだけ完了したかと、その後に学校がその学生を上のレベルに進ませたかどうかを比べました。定義が重要なので、すべて示します。
- 対象:英語準備課程の学生1,033人。A1からプロフィシエンシー(proficiency)トラックまでです。
- 期間:2025–26年度。10月から5月まで、8週間のモジュール4つで行われました。
- 宿題:学校は毎週、各クラスのレベルに合わせたAvoLingoの練習を課しました。内容は、AIスピーキング(AIチューターとの会話)、発音、文法、語彙の組み合わせです。この記事でいう「スピーキング宿題」は、会話だけではなく、この毎週のセット全体を指します。
- 宿題の完了率:あるモジュールで学生に出されたAvoLingoの宿題のうち、その学生が完了した割合。区分は「宿題なし」「25%以下」「75%以上」です。
- 1つ上のレベルに進む:8週間のモジュールが終わるたびに、学校は、学生が次のレベルに進むか、もう一度くり返すかを決めます。これは学校自身のレベル判定で、AvoLingoのスコアは使われていません。
- 分析の単位:モジュールから次のモジュールへの移行。分析の対象は、タスクを1つ以上行った学生による1,719件の移行です。
このデータからわからないことは?
宿題が進歩の原因だったことは、このデータからはわかりません。限界は4つあります。
- 対照群がない。宿題をするか、しないかを割り当てられた人はいません。学生が自分で選び、私たちはそれを観察しました。
- 意欲のある学生は両方をする。宿題を終える学生は、おそらく授業にも出席し、復習し、質問もします。98%と42%の差の一部は、タスクではなく学生自身を反映しています。
- 1校、1年のデータである。BAUのプログラム、教職員、学生は、ほかのプログラムと同じではありません。ほかの場所では、この傾向がもっと弱いことも、強いこともありえます。
- 結果の指標はレベルの進級であり、スピーキングテストではない。これらの学生について独立したスピーキングのスコアはないため、進歩のうちどれだけがスピーキングの進歩だったかはわかりません。
宿題一般についての研究にも、同じ弱点があります。Cooper、Robinson、Patallによる1987〜2003年の宿題研究の統合は、宿題が学業成績に良い影響を与えることを示す、おおむね一貫した証拠を見いだしました。同時に、どの種類の研究にも設計上の欠陥があったとしています。
データの中で行った3つの確認
当然出てくる反論は、優秀な学生ほど単に宿題を多くしただけではないか、というものです。次の3つの比較は、この反論にある程度答えます。
- 同じ学生の、2つの結果。162人の学生は、あるモジュールの後には上のレベルに進み、別のモジュールの後にはくり返しました。この学生たちの宿題の完了率は、上のレベルに進む前のモジュールでは47%、くり返す前のモジュールでは33%でした。学生を本人と比べるので、能力のような固定的な違いの影響は除かれます。
- 2度目の機会。モジュールをくり返した学生のうち、その後に宿題の半分以上を完了した学生は、88%が次のモジュールで上のレベルに進みました。半分未満だった学生では47%でした。
- それまでの結果を考慮に入れる。それまでの宿題と結果を考慮しても、完了率が10ポイント高くなるごとに、上のレベルに進むオッズが約1.3倍になるという関連が残りました。
これらの確認は懸念を小さくしますが、なくすわけではありません。学生は、私たちには見えない理由で厳しいモジュールを過ごし、宿題が減り、授業での成績も下がることがあります。
学校は実際に何をした?
BAUは、この練習を、学生が自分で見つける任意の追加教材ではなく、学校が決める毎週の習慣にしました。注目すべき点は3つあります。
- 毎週、レベルに合わせて。全員に同じ教材群を用意するのではなく、各クラスが毎週、自分のレベルの練習を受け取りました。
- 取り組みにはばらつきがあった。年間で学生の79%が宿題のタスクを1つ以上完了し、343人が50以上のタスクを完了しました。まったく行わなかった学生もいて、「宿題なし」のグループがあるのはそのためです。
- 学校は利用を拡大した。BAUは2025年9月に学生700人で始めました。2026年9月時点では、学生向け2,000、教員向け300のライセンスを保有しています。
個々の教員が教え方をどう変えたかについて、授業ごとの記録はありません。そのため、その点については何も主張しません。
プラットフォームはどれくらい使われた?
1年間で、1,033人の学生が36,212件の宿題タスクを完了しました。そのうち25,887件がAIとの会話です。
| 指標(2025年10月〜2026年5月) | 合計 |
|---|---|
| 学生数 | 1,033 |
| 完了した宿題タスク | 36,212 |
| 完了したAIとの会話 | 25,887 |
| 学生がAIに書いたメッセージ | 544,725 |
| 発音して採点された単語 | 164,865 |
AIのフィードバックの後、スコアは上がる?
同じタスクでは、上がりました。AIのフィードバックの後に学生がもう一度取り組むと、調べた2種類のタスクの両方で平均スコアが上がりました。
| タスク | 1回目 | フィードバック後 |
|---|---|---|
| クイズ | 40 | 84 |
| チャット | 49 | 70 |
スコアは、同じタスクでの100点満点の平均です。これは、学生がフィードバックをすぐに生かしたことを示しています。1か月後にどれだけ定着していたかは示していません。また、再挑戦することを選ぶ学生は、そうしない学生と異なる可能性があります。
より広い研究も同じ方向を示しています。HattieとTimperleyによるフィードバック研究のレビューは、フィードバックを学習に最も強く影響する要因の1つとし、その効果はフィードバックの種類と与え方によって変わると述べています。Bibauwらによる17件の研究のメタ分析では、対話システムを使った会話練習が第二言語の熟達度に中程度の効果(d = 0.58)を持つことが示されました。これらの研究は効果を検証するために設計されたものですが、私たちの利用データはそうではありません。
準備課程の責任者とコーディネーターは、ここから何を得られる?
- ログイン数ではなく、モジュールごとの完了率を追う。ここで結果を分けた指標は完了率でした。どの提供事業者にも、学生別・クラス別の完了率を求めましょう。
- 宿題をしていないグループを早く見つける。モジュール内で宿題をしなかった学生が上のレベルに進んだ割合は42%でした。連絡を取るべきなのは、最後ではなく最初の数週間です。
- 練習は毎週出し、レベルに結びつける。BAUはそのように運用しました。自校のシラバスから作った練習は、必須にしやすくなります。計画の立て方の一例として、ESPのコース設計のガイドをご覧ください。
- 2回目の取り組みを組み込む。フィードバックの後に再挑戦するとスコアが上がりました。1回目だけでなく、再挑戦も評価に入れましょう。
- レベル判定は自校の教職員が行う。BAUでは、誰が上のレベルに進むかを学校が決めました。AI練習は教員と並んで機能するものです。教員の判断材料を増やすもので、教員の判断に代わるものではありません。
パイロットを行うなら、たとえばクラス間の比較を最初から計画しておきましょう。そうすれば、私たちがここで言える以上のことが言えます。コースと課題の設定方法は大学向けのAvoLingoで紹介しています。デモをご希望の場合は、プログラムについてお聞かせください。
よくある質問
これは対照研究ですか?
いいえ。1学年度の観察データです。対象は1つの大学の学生1,033人で、対照群も無作為の割り当てもありません。示しているのは、宿題の完了と上のレベルに進むこととの関連であり、因果関係の証明ではありません。
宿題はどれくらいすれば十分ですか?
このデータから基準となる値はわかりません。75%以上を完了した学生は98%の割合で上のレベルに進み、半分より多くを完了した学生はどのレベルでも88%以上の割合で進みました。完了率が10ポイント高くなるごとにオッズも高くなっていたので、範囲全体を通じて、多いほど良い結果でした。
誰が上のレベルに進むかは、AvoLingoのスコアで決まったのですか?
いいえ。上のレベルに進むかどうかは、8週間のモジュールが終わるたびに学校自身が行ったレベル判定で、AvoLingoのスコアとは独立に決められました。
小中高(K-12)にも当てはまりますか?
わかりません。対象は、集中英語プログラムで学ぶ大学準備課程の学生です。学習者の年齢が低い、週あたりの時間が少ない、評価方法が違う、といった条件で結果は変わりえます。小中高での結果は公表していません。
スピーキングが伸びたことの証明になりますか?
これだけでは、なりません。結果の指標は、学校が決めたレベルの進級です。フィードバック前後のスコアが示しているのは、フィードバック後に同じタスクで向上したことであり、より限定的な主張です。
参考資料
- AvoLingoプラットフォームのデータ、Bahçeşehir大学英語準備課程、2025年10月〜2026年5月(学生1,033人)。レベルの判定は学校が行いました。
- Cooper, Robinson and Patall (2006), Does homework improve academic achievement? A synthesis of research, 1987–2003, Review of Educational Research 76(1)
- Hattie and Timperley (2007), The power of feedback, Review of Educational Research 77(1)
- Bibauw, Van den Noortgate, François and Desmet (2022), Dialogue systems for language learning: a meta-analysis, Language Learning & Technology 26(1)
AvoLingoチームが